华为云MRS与流计算、OLAP 构建企业智能数据底座的实践路径
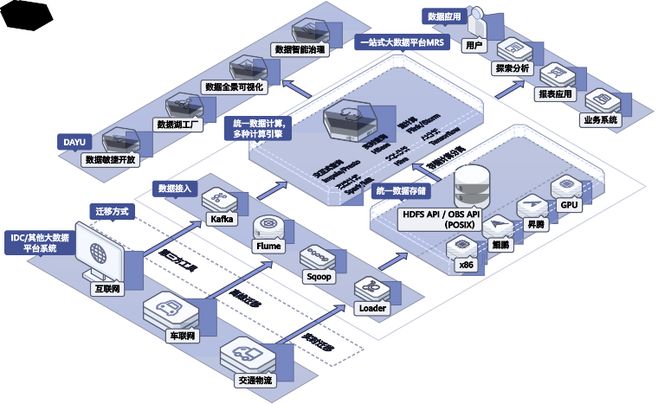
在数字化转型的浪潮中,企业对数据处理能力的需求正从单一的批处理向实时化、交互式、智能化方向演进。华为云MapReduce服务(MRS)作为大数据处理的核心平台,以其对Hadoop生态的深度兼容和企业级增强,成为支撑流计算与OLAP场景的关键基础设施。本文将从技术架构、场景适配和华为云EI企业智能的能力整合三个维度,分析MRS如何帮助企业构建统一的数据底座。
一、MRS的技术定位:不止于MapReduce
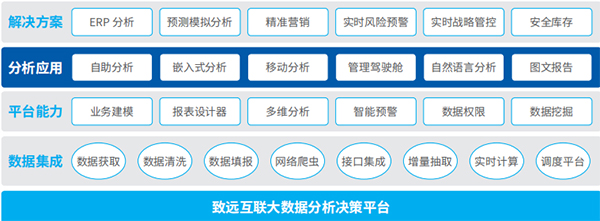
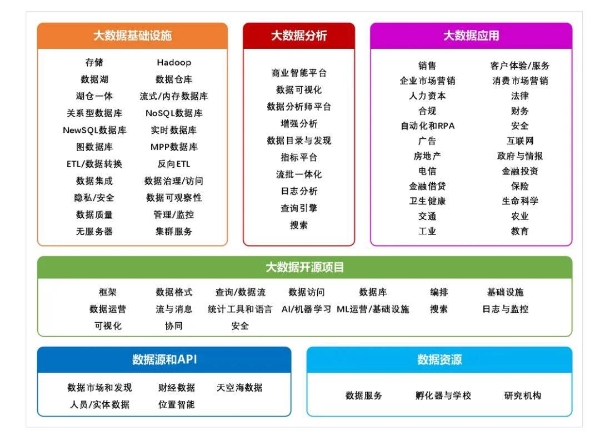
许多人将MRS简单理解为Hadoop MapReduce的托管服务,但实际上,华为云MRS是一个综合性大数据集群服务,涵盖了HDFS、Yarn、Hive、HBase、Spark、Flink、Kafka等多种组件。这意味着MRS同时具备批处理、流处理、交互式查询和NoSQL存储能力。对企业而言,这种一体化平台降低了多套系统并行运维的复杂度,也为流计算和OLAP场景提供了同一底座上的技术支撑。
在集群部署层面,MRS支持存算分离架构,结合对象存储OBS实现存储资源的弹性扩展,计算节点可按业务负载独立伸缩。这一设计对需要处理海量历史数据又面临突发流量的互联网数据服务场景尤为重要。
二、流计算场景下的MRS实践
流计算的核心诉求是低延迟、高吞吐和Exactly-Once语义保证。MRS集成了Flink作为主流流计算引擎,并在此基础上做了多项企业级优化:一是与Kafka的深度集成,支持数据从消息队列到流处理引擎的无缝接入;二是提供Flink SQL能力,降低流式作业的开发门槛;三是与MRS Manager运维平台打通,实现作业监控、告警和资源调度的统一管理。
在实际应用中,某互联网数据服务企业需要实时处理用户行为日志并输出风控指标。借助MRS的Flink集群和Kafka组件,该企业将端到端延迟控制在秒级以内,同时利用MRS的弹性伸缩能力应对日活波动带来的流量峰值。这一案例说明,MRS在流计算场景中并非单纯的组件堆叠,而是通过运维集成和资源管理形成了可落地的解决方案。
三、OLAP能力的多引擎适配
OLAP场景对查询延迟和并发能力有明确要求。MRS在这一领域提供了多引擎选择:Hive适合大规模批式分析,Spark SQL在交互式查询中表现均衡,ClickHouse组件则面向高并发点查和实时报表场景。企业可以根据数据规模、查询模式和并发量灵活选型,而不必为每一种分析需求单独搭建平台体系。
值得关注的是,MRS在存算分离模式下结合OBS和弹性计算资源,能够支撑OLAP负载的按需扩缩。对于互联网数据服务中常见的“报表高峰期集中在固定时段”这一特征,按量付费的弹性资源比固定集群更具成本效率。MRS与华为云数据湖探索(DLI)等服务之间可以形成互补,MRS侧重集群化自管理分析,DLI侧重Serverless化查询,企业可按团队能力与合规要求合理分工。
四、与华为云EI企业智能的协同价值
MRS的价值不仅在于自身功能,更在于它与华为云EI(企业智能)体系的协同。MRS作为数据底座,为上层AI训练和推理提供清洗后的结构化数据;EI侧提供的ModelArts等平台则可以消费MRS中的特征数据,形成从数据存储、处理到模型训练、预测的闭环。对于互联网数据服务企业而言,这一闭环意味着用户画像、推荐排序、异常检测等智能化应用可以在同一云平台上完成数据流转,减少跨平台数据搬运带来的延迟和安全风险。
华为云MRS的定位已经超越了传统MapReduce框架的范畴,它在流计算和OLAP两个关键方向上通过组件集成、运维统一和弹性架构提供了可实践的技术路径。对企业而言,选择MRS本质上是在选择一套与华为云EI生态协同的数据基础设施。需要提醒的是,技术选型应回到业务本身:流计算是否真正需要Flink的Event Time语义、OLAP查询模式是点查为主还是大宽表扫描为主,这些问题的答案决定了MRS内部各组件的配置策略,也决定了平台投入能否转化为可见的业务收益。
如若转载,请注明出处:http://www.fwfmfx.com/product/54.html
更新时间:2026-11-21 01:39:42