AI背后的"算力工厂" 互联网数据服务如何塑造智能未来
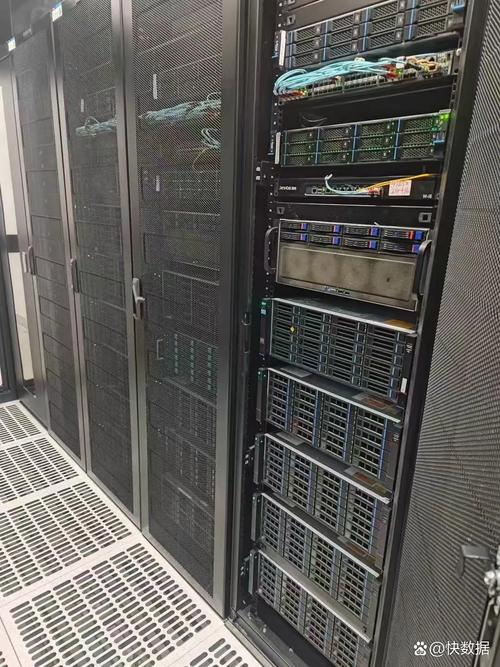
当你在手机上调戏语音助手、用AI绘画工具生成一幅奇幻画作,或是让ChatGPT为你写一封工作邮件时,你感受到的可能是「智能」的轻盈与便捷。但在这背后,是一场沉默而庞大的工程——数以万计的服务器在嗡鸣,数据像血液一样在全球网络中奔流,巨型机房消耗着堪比中型城市的电力,这一切都浓缩成一个词:算力。而支撑算力的「工厂」,正是互联网数据服务(IDC)。
算力:AI时代的「电力」
如果说数据是AI的燃料,那么算力就是引擎。训练一个像GPT-4这样的大模型,需要在成千上万块GPU上运行数周甚至数月,处理万亿级参数。OpenAI曾透露,训练GPT-4的算力成本超过1亿美元。这种规模的运算需求,个人电脑根本无法承载,只能依赖专业化的互联网数据中心(IDC)——也就是「算力工厂」。
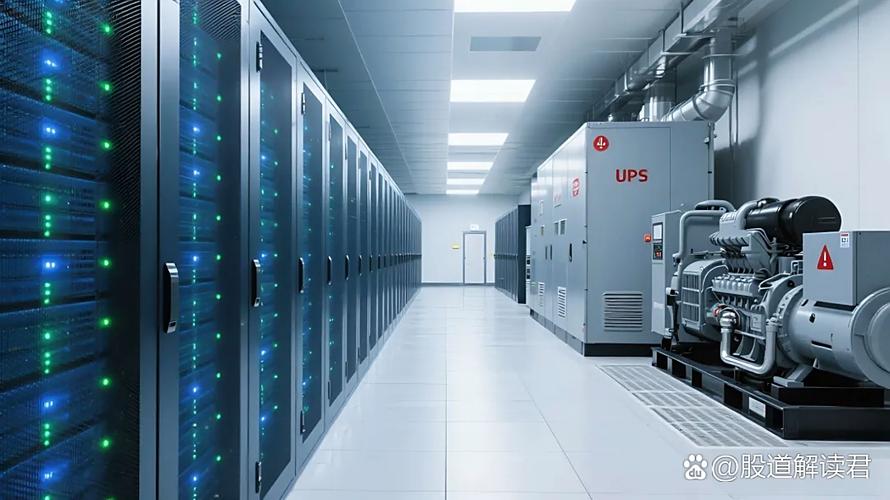
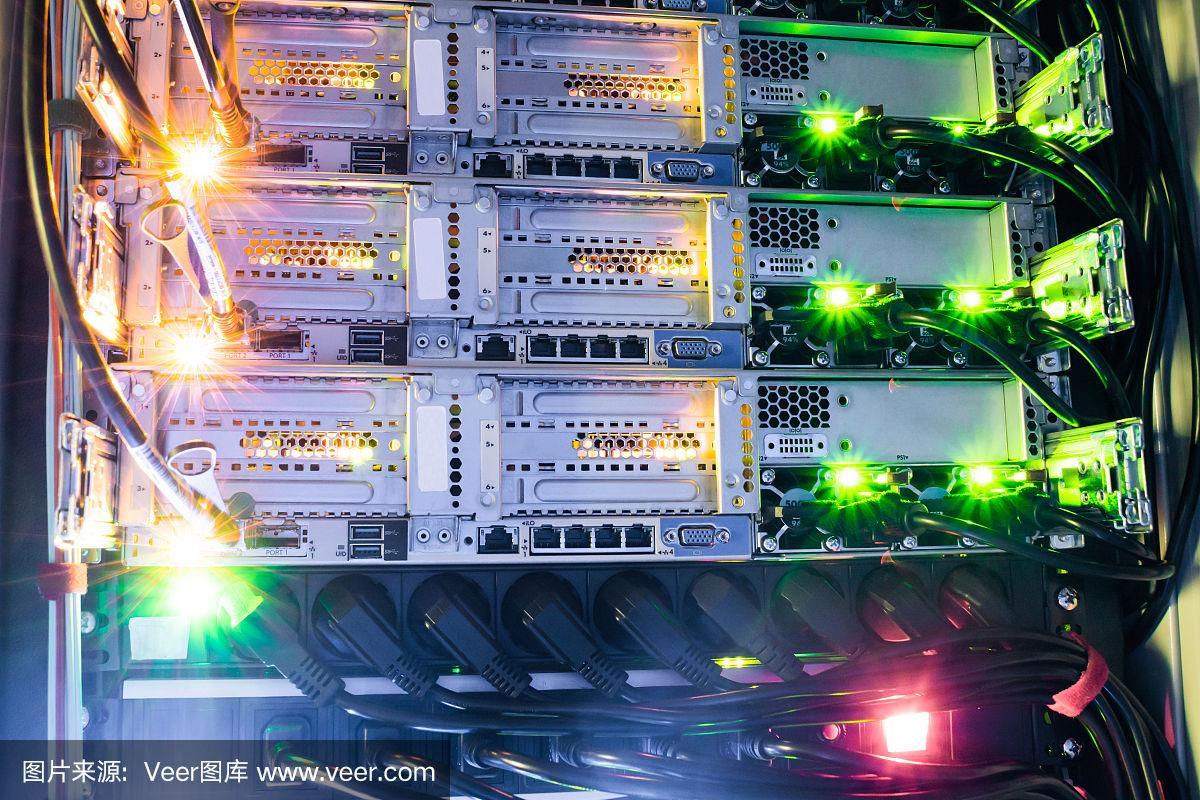
与传统数据中心不同,现代算力工厂的核心不再是存储,而是「计算」。它们配备高性能GPU集群(如NVIDIA H100)、高速互联网络(如InfiniBand)以及液冷散热系统。在这里,一台AI服务器每秒能完成数百万亿次运算,而这样的服务器在大型数据中心里有数万台。
数据服务不止于托管
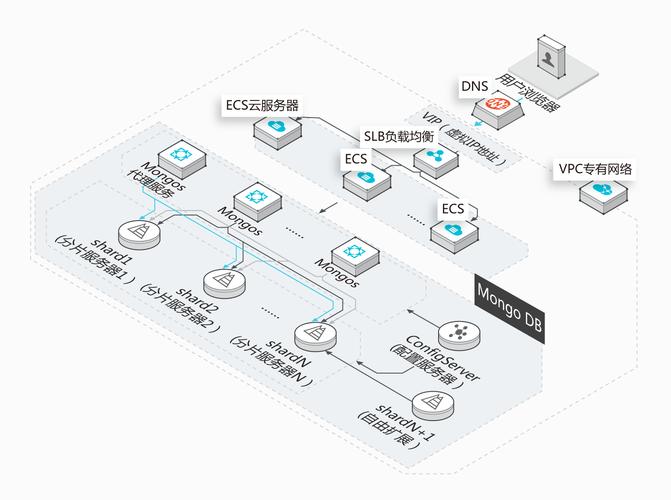
互联网数据服务早已超越了最早的「服务器托管」阶段。今天的IDC服务商提供的是从基础设施到AI平台的全栈能力:
- 基础设施即服务(IaaS):提供虚拟机、裸金属服务器、GPU云实例。
- 平台即服务(PaaS):集成AI开发框架、模型微调工具、数据标注平台。
- MaaS(模型即服务):直接调用预训练大模型接口,按需付费。
以亚马逊AWS、微软Azure、阿里云为代表的云厂商,本质上也是全球最大的「算力工厂」运营商。它们将分布在各地的数据中心连成一张巨网,让AI开发者可以像用水电一样使用算力。
规模竞赛:钢铁、硅与冷却液
算力工厂的竞争,首先是规模竞赛。2023年,Meta宣布建造配备 16,000块NVIDIA H100 GPU 的AI集群;微软与OpenAI联手打造了包含 数万块GPU 的超算中心;谷歌则推出了 TPU v5p 集群,峰值算力达每秒数百亿亿次。在中国,「东数西算」工程规划了八大枢纽节点,目标是让西部的清洁能源支撑东部的 AI 算力需求。
这些工厂的外观越来越不像传统机房:一排排黑色机柜密不透风,液冷管道纵横交错,运维人员穿着防静电服穿梭在模块化建筑中。它们通常建在电力便宜、气候凉爽的地区(如爱尔兰、挪威、宁夏中卫),因为散热和电费是最大的运营成本。一个超大规模数据中心的功耗可达 100兆瓦,相当于10万户家庭的用电量。
绿色算力:可持续发展的挑战
当AI狂飙突进,环境账单也随之而来。据国际能源署估算,到2026年,全球数据中心能耗可能达到 1,000太瓦时,接近日本全国用电量。因此,科技巨头纷纷承诺「碳中和数据中心」:使用风电、光伏,采用海水冷却、AI优化温控系统。微软甚至试验了将数据中心沉入海底的「Project Natick」,利用海水自然冷却。
互联网数据服务商也在推动算力网络——通过网络调度,将非实时任务(如模型训练)迁移到绿电丰富的西部节点,而对延迟敏感的推理任务则留在靠近用户的边缘节点。
边缘与云:算力工厂的「毛细血管」
未来的算力工厂不会是单一的摩天大楼式集群,而是「云-边-端」协同的立体网络。训练在云端,推理在边缘——比如自动驾驶汽车需要在毫秒级响应,就必须在本地或基站侧进行边缘计算,而高精度地图更新和模型迭代则交给云端超算。互联网数据服务正从集中走向分布,变成无处不在的智能基础设施。
看不见的工厂,看得见的未来
下一次你对着AI说出「你好」,或许不会想到背后是数万块芯片的协同运转和一整座城市的电力支撑。但正是这些庞大、精密、耗电又不断进化的算力工厂,让AI从论文里的公式变成了你手机里的魔法。互联网数据服务,这个听起来技术味十足的词,恰恰是智能时代最坚实的基础。
当算力像电力一样普及,创新的门槛才会真正降低。而这场关于「智」与「能」的基建长跑,才刚刚开始。
如若转载,请注明出处:http://www.fwfmfx.com/product/39.html
更新时间:2026-09-19 09:15:34